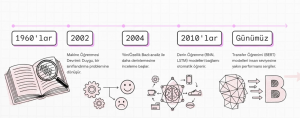
Duygu analizi (sentiment analysis) çalışmaları, tarihsel süreçte manuel yöntemlerden karmaşık yapay zeka modellerine doğru evrilen, belirgin kırılma noktalarıyla şekillenmiş bir gelişim çizgisine sahiptir.
ERKEN DÖNEM VE KÖKLER (1900’LERİN ORTASI – 2000 ÖNCESİ)
Duygu analizinin temelleri, modern bilgisayarlardan önceye, sosyal bilimlerdeki içerik analizi çalışmalarına dayanır.
Manuel İçerik Analizi: 20. yüzyılın başlarında, metinlerden yazarın doğasını veya eğilimini çıkarmak için kelime sayımları kullanılıyordu. Örneğin, 1940’larda kişilik özelliklerini ölçmek için frekans sayımları yapılmıştır.
İlk Sözlükler: 1960’larda bilgisayarların gelişimiyle, “General Inquirer” (Stone et al., 1966) gibi ilk sistematik içerik analizi yazılımları ve duygu sözlükleri (lexicons) ortaya çıkmıştır. Bu dönemde araştırmacılar, psikolojik durumları belirlemek için kelimelerin bağlamdan bağımsız anlamlarına odaklanmışlardır.
Öznellik ve Etki (Affect): 1990’larda Rosalind Picard’ın “Affective Computing” (Duygusal Hesaplama) çalışmaları ve Wiebe’nin öznellik (subjectivity) üzerine yaptığı dilbilimsel çalışmalar, alanın teorik altyapısını oluşturmuştur.
TERİMLEŞME VE İNTERNET ÇAĞININ BAŞLANGICI (2000’LERİN BAŞI)
Bu dönem, alanın resmen tanımlandığı ve “Sentiment Analysis” ile “Opinion Mining” terimlerinin literatüre girdiği dönemdir.
Kavramsal Doğuş: “Sentiment Analysis” terimi ilk kez Nasukawa ve Yi (2003) tarafından, “Opinion Mining” terimi ise Dave et al. (2003) tarafından kullanılmıştır. Web 2.0 ve sosyal medyanın yükselişiyle birlikte, dijital ortamda artan kullanıcı yorumları bu alana olan ilgiyi patlatmıştır.
Sözlük Tabanlı (Lexicon-Based) Yöntemler: İlk dönemlerde araştırmacılar, kelimelerin kutupsallığını (pozitif/negatif) belirlemek için önceden tanımlanmış kelime listeleri kullanmışlardır. Turney (2002) gibi araştırmacılar, kelimelerin anlamsal yönelimini belirlemek için denetimsiz yöntemler (PMI-IR) geliştirmiştir.
MAKİNE ÖĞRENMESİ DEVRİMİ (2002 SONRASI)
Bu dönem, duygu analizinin basit kelime sayımından istatistiksel sınıflandırma problemine dönüştüğü en kritik kırılma noktalarından biridir.
Makine Öğrenmesine Geçiş: Pang, Lee ve Vaithyanathan’ın (2002) çalışması, duygu analizini bir metin sınıflandırma problemi olarak ele almış ve Destek Vektör Makineleri (SVM), Naive Bayes gibi denetimli öğrenme algoritmalarının, insan tarafından oluşturulan sözlüklerden daha yüksek performans gösterdiğini kanıtlamıştır.
Doğruluk ve Yorumlanabilirlik Takası: Bu dönemde araştırmacılar, sözlük tabanlı yöntemlerin sunduğu “yorumlanabilirlik” (hangi kelimenin sonucu etkilediğini görme) ile makine öğrenmesinin sunduğu “yüksek doğruluk” arasında bir denge kurmaya çalışmışlardır.
ANALİZ SEVİYELERİNİN DERİNLEŞMESİ (2004 VE SONRASI)
Araştırmalar sadece dökümanın genel duygusunu (pozitif/negatif) bulmaktan öteye geçerek daha detaylı analizlere yönelmiştir.
Yön/Özellik Bazlı Analiz (Aspect-Based): Hu ve Liu (2004), metinlerin sadece genel duygusunu değil, bahsedilen varlığın özelliklerine (örn. telefonun pili, ekranı) yönelik duyguları da analiz eden “özellik tabanlı özetleme” kavramını tanıtmıştır. Bu, endüstriyel uygulamalar için kritik bir adım olmuştur.
Duygu ve Fikir Ayrımı: Araştırmacılar, rasyonel değerlendirmeler (fikirler) ile duygusal tepkiler (hisler) arasındaki farkları modellemeye başlamışlardır.
DERİN ÖĞRENME VE VEKTÖR UZAYI MODELLERİ (2010’LAR)
Geleneksel makine öğrenmesi yöntemlerinin yerini, veriden otomatik özellik çıkarımı yapabilen derin öğrenme mimarileri almaya başlamıştır.
Kelime Gömüleri (Word Embeddings): “Bag-of-words” (kelime çantası) yaklaşımından, kelimelerin anlamsal ilişkilerini vektör uzayında temsil eden Word2Vec, GloVe ve Sentiment Embeddings gibi yöntemlere geçiş yapılmıştır. Bu sayede kelimelerin bağlamsal ve duygusal benzerlikleri daha iyi yakalanmıştır.
Sinir Ağları (Neural Networks): Yinelemeli Sinir Ağları (RNN), Uzun Kısa Süreli Bellek (LSTM) ve Evrişimli Sinir Ağları (CNN) gibi mimariler, metindeki sıralı bilgiyi ve uzun vadeli bağımlılıkları modelleyerek performansı artırmıştır. Özellikle LSTM, metin içindeki ironi ve karmaşık yapıları çözmede etkili olmuştur.
TRANSFER ÖĞRENİMİ VE DİL MODELLERİ (GÜNÜMÜZ)
Son ve en güncel kırılma noktası, büyük dil modellerinin ve transfer öğreniminin (transfer learning) sahneye çıkışıdır.
Transformer Mimarileri: BERT (Bidirectional Encoder Representations from Transformers) ve RoBERTa gibi modeller, bağlamı hem sağdan hem soldan okuyarak dilin çok daha derin bir temsilini öğrenmiştir. Bu modeller, büyük veri setlerinde ön eğitim (pre-training) alıp, daha küçük duygu analizi veri setlerine uyarlanarak (fine-tuning) insan benzeri doğruluk oranlarına ulaşmıştır.
Genelleştirme Yeteneği: Transfer öğrenimi sayesinde, bir alanda (örn. film yorumları) eğitilen modellerin başka alanlara (örn. ürün yorumları) başarıyla uygulanabilmesi sağlanmış, bu da etiketli veri ihtiyacını azaltmıştır.
GELECEK VİZYONU: SENTIC COMPUTING VE KAVRAMSAL ANALİZ
Geleceğe yönelik çalışmalarda, sadece istatistiksel analizlerin (syntactics) ötesine geçerek, metnin anlamsal (semantics) ve kullanımsal (pragmatics) katmanlarını birleştiren hibrit yaklaşımlar öne çıkmaktadır.
Sentic Computing: Bu yaklaşım, yapay zeka ve dilbilimi birleştirerek, metni “kelime çantası” olarak değil, “kavram çantası” (bag-of-concepts) ve nihayetinde “anlatı çantası” (bag-of-narratives) olarak işleyen sistemler geliştirmeyi hedefler. Amaç, makinenin sadece istatistiksel tahmin yapması değil, metni insan gibi anlamasıdır.
Duygu Arkları (Sentiment Arcs): Son dönemde, edebi eserlerdeki duygu değişimlerinin zaman içindeki akışını (duygu arklarını) modelleyerek hikaye yapılarının analiz edilmesi de yeni bir çalışma alanı olarak belirmiştir.
Not: Bu içerik, ilgili akademik kaynakların Google NotebookLM kullanılarak analiz edilmesi ve derlenmesiyle oluşturulmuştur.
KAYNAK
Hartmann, J., Heitmann, M., Siebert, C., & Schamp, C. (2023). More than a Feeling: Accuracy and Application of Sentiment Analysis. International Journal of Research in Marketing, 40(1), 75-87.