Tezimizi ya da makalemizi yazarken verilerin analizine başlamadan önce kontrol etmemiz gerekenlerden biri de, veri setimiz için kullanacağımız testin varsayımlarının sağlanıp sağlanmadığıdır. Varsayımları kontrol etmezsek ve yaptığımız analizde varsayımlar ihlal edilmişse, sonuçlarda Tip I hata olasılığı yüksektir. Bu durumda araştırmanızdan elde edilen bulgular tartışmalıdır. O halde topladığımız/kullandığımız verinin kullanmayı planladığımız istatistiksel testin varsayımlarını karşılayıp karşılamadığını kontrol etmeliyiz.
Veri, kullanmayı planladığımız analizin varsayımlarını karşılıyor mu?
Uygun olmayan bir veri yapısına yanlış bir istatistiksel yöntem uygulamak, elde edilen p değerlerinin, güven aralıklarının ve etki büyüklüklerinin hatalı yorumlanmasına yol açabilir. Hangi varsayımın hangi ölçüde önemli olduğu, kullanılan testin yapısına, örneklem büyüklüğüne, değişkenlerin ölçüm düzeyine ve araştırma desenine göre değişir. Bu nedenle kullanacağınız istatistiksel testin hangi durumlarda nasıl kullanılması gerektiğini de bilmeniz gerekir.
Varsayım kontrolünü üç başlık altında düşünmek pratik bir yaklaşım sağlar. O yüzden bu konuyu üç başlık altında vermenin uygun olacağını düşündüm: parametrik analizler, nonparametrik analizler ve çok değişkenli analizler için gerekli varsayımlar. Ardından daha detaylı bir öğrenme sağlamak amacıyla her teste ait varsayımları da yeniden sınıflandırdım.

1. Parametrik testlerde temel varsayımlar
t-Testi, ANOVA, Pearson korelasyonu ve doğrusal regresyon gibi parametrik yöntemler, belirli dağılımsal ve yapısal koşullar altında daha güvenilir sonuçlar verir. Ancak bütün parametrik testlerin aynı varsayımlara sahip olduğunu düşünmeyin lütfen. Varsayımlar analizden analize de değişir.
Örneğin bağımsız örneklemler t-Testinde grup içindeki dağılım ve varyansların homojenliği önemliyken, doğrusal regresyonda özellikle artıkların dağılımı, doğrusallık, bağımsızlık ve sabit varyans varsayımlarını incelemek gerekir.
Normallik
Normallik varsayımı, değişkenin normal dağılımı ve model artıklarının normal dağılımı olmak üzere iki farklı konu üzerinden değerlendirilmelidir. Örneğin regresyonda temel mesele, bağımlı değişkenin tek başına kusursuz biçimde normal dağılması değildir. Modelin artıklarının yapısı ve özellikle küçük örneklemlerdeki dağılım özellikleri daha önemlidir. t-Testinde ise toplanan verilerin normal dağılması yeterlidir.
Normalliği değerlendirirken tek başına bir normallik testinin p değerine bakmak yerine birden fazla kanıtı birlikte değerlendirmek daha sağlıklıdır:
- Q-Q grafiği,
- histogram,
- çarpıklık ve basıklık değerleri,
- gerektiğinde Shapiro-Wilk gibi normallik testleri.
Özellikle örneklem büyüdükçe normallik testleri küçük sapmalara karşı oldukça duyarlı hale gelebilir. Bu nedenle p > .05 olduğunda dağılım normal, p < .05 olduğunda dağılım normal değil biçimindeki bir yaklaşımı kullanmamanızı öneririm. Grafikleri incelemek iyi bir yoldur.
Varyansların homojenliği
İki veya daha fazla grubun karşılaştırıldığı bazı parametrik testlerde grupların varyanslarının benzer olması beklenir.
Bu varsayım özellikle bağımsız örneklemler t-Testi ve ANOVA gibi analizlerde önem taşır.
En yaygın kullanılan yöntemlerden biri Levene testidir. Test sonucunun anlamlı olmaması (p > .05), varyansların homojenliği varsayımının karşılandığını gösterir. Yine, burada da, yalnızca p değerine bakmak yerine grup büyüklükleri ve dağılımların genel yapısını da dikkate almalısınız.
Varyansların homojenliği sağlanmadığında nonparametrik testlere geçmek zorunda değilsiniz. Örneğin t-Testinde Welch düzeltmesi, ANOVA’da ise varyans eşitsizliğine daha dayanıklı (robust testler, örneğin Welch ANOVA) alternatifler kullanılabilir.
Bağımsız gözlemler
Bu varsayım araştırma deseninin bir özelliğidir.
Bir katılımcının ölçümünün başka bir katılımcının ölçümünden bağımsız olması gerekir. Aynı kişiye ait birden fazla kez ölçüm alınması, öğrencilerin aynı sınıflarda kümelenmesi veya bireylerin aynı aile/kurum içinde yer alması gibi durumlarda gözlemler birbirinden bağımsız olmayabilir.
Dolayısıyla bağımsızlık varsayımını SPSS çıktısında aranacak bir p değeri olarak düşünülmemelidir Örneğin regresyonda Durbin-Watson istatistiği ardışık bağımlılığın değerlendirilmesinde kullanılabilir; ancak bu, bağımsızlık varsayımının bütün olası ihlallerini test eden genel bir yöntem değildir.
Doğrusallık
Pearson korelasyonu ve doğrusal regresyon gibi yöntemlerde değişkenler arasındaki ilişkinin doğrusal olması beklenir.
Bu nedenle analizden önce serpilme grafiklerine bakmak oldukça yararlıdır. İki değişken arasındaki ilişki güçlü görünse bile ilişki eğrisel bir yapı gösteriyorsa doğrusal korelasyon veya regresyon uygun bir model olmayabilir.
Aykırı değerler
Aykırı değerler, özellikle küçük örneklemlerde analiz sonuçlarını ciddi biçimde etkileyebilir.
Tek değişkenli aykırı değerler için:
- boxplot,
- z skorları,
- histogramlar
kullanılabilir.
Birden fazla değişken birlikte değerlendirildiğinde ise Mahalanobis uzaklığı daha uygun bir araçtır. Regresyon analizlerinde ayrıca Cook’s Distance gibi ölçüler gözlemlerin model üzerindeki etkisini değerlendirmek için kullanılabilir.
Burada da önemli bir ayrım vardır: Aykırı bir gözlem bulundu diye doğrudan veri setinden çıkarılmamalıdır. Öncelikle bunun veri giriş hatası mı, ölçüm hatası mı, yoksa gerçekten gözlenen ve araştırma açısından anlamlı bir durum mu olduğu değerlendirilmelidir.

2. Nonparametrik testler “varsayımsız” mı?
Hayır.
Nonparametrik kavramı bazen hiçbir varsayımı olmayan test şeklinde anlaşılabiliyor. Bu doğru değildir.
Nonparametrik yöntemler, belirli dağılımsal varsayımlara parametrik yöntemler kadar bağımlı değildir ve bu nedenle farklı veri koşullarında daha esnek biçimde kullanılabilir. Ancak parametrik testlerin de kendi varsayımları ve gereklilikleri vardır.
Mann-Whitney U, Wilcoxon, Kruskal-Wallis ve Friedman gibi yöntemler bu gruba örnek verilebilir. Ki-kare testleri de kategorik verilerle çalışırken kullanılan dağılımsal açıdan farklı bir yaklaşım sunar.
Ölçüm düzeyi
Nonparametrik testlerin önemli avantajlarından biri, ordinal verilerle de çalışırken de kullanabilmemizdir.
Örneğin Likert tipi sıralı veriler veya normal dağılımdan ciddi biçimde uzaklaşan sürekli değişkenler için bazı nonparametrik yöntemler uygun olabilir.
Ancak burada da veri normal değilse nonparametrik test kullanılır şeklindeki bir yaklaşım doğru değildir.
Örneklem büyüklüğü, dağılımın şekli, ölçüm düzeyi, araştırma sorusu ve kullanılacak testin özellikleri birlikte değerlendirilmelidir.
Bağımsızlık ve araştırma deseni
Mann-Whitney U testi bağımsız iki grubun karşılaştırılmasında kullanılırken, Wilcoxon işaretli sıralar testi ilişkili iki ölçüm için kullanılır.
Örneğin aynı katılımcıların müdahale öncesi ve sonrası puanlarını karşılaştırıyorsanız iki bağımsız grup varmış gibi Mann-Whitney U kullanmak doğru değildir.
Dağılımların benzerliği
Mann-Whitney U veya Kruskal-Wallis gibi testlerde sonuçları yalnızca dağılımların medyanları karşılaştırılıyor şeklinde yorumlamak her durumda doğru değildir.
Grupların dağılım şekilleri birbirinden belirgin biçimde farklıysa testin neyi karşılaştırdığına ilişkin yorum da değişebilir. Bu nedenle analiz sonuçları ve dağılımlarla ilgili yorum yapma becerimizi de geliştirmek bizim bir sorumluluğumuz diye düşünüyorum.
Karşılaştırma yaparken, grup dağılımlarını boxplot veya histogramlarla incelemek önemli.
Ki-kare testinde beklenen frekanslar
Ki-kare analizinde hücrelerdeki beklenen frekanslara dikkat etmemiz gerekir.
Beklenen frekansların çok küçük olmaması gerekir ve beklenen frekanslarda 5 değeri bir sınır olarak kullanılır. Ancak bu, bütün hücrelerin mutlaka 5’in üzerinde olması gerektiği şeklinde katı ve evrensel bir kural da değildir.
Özellikle çok sayıda kategorinin bulunduğu ve örneklemin küçük olduğu tablolarda beklenen frekansların düşmesi, ki-kare yaklaşımının güvenilirliğini etkileyebilir. Böyle durumlarda kategorilerin yeniden düzenlenmesi veya uygun alternatif testlerin kullanılması gerekebilir.
3. Çok değişkenli analizlerde varsayımlar
MANOVA, çoklu doğrusal regresyon, faktör analizi ve diskriminant analizi gibi yöntemlerde aynı anda birden fazla değişken dikkate alındığı için varsayım kontrolü de daha kapsamlıdır.
Yalnızca “A değişkeni normal dağılmış mı?” sorusuna evet yanıtını vermemiz yeterli değildir.
Değişkenlerin birlikte nasıl davrandığına da bakmamız gerekir.
Çok değişkenli normallik
Analizimizde iki veya daha fazla bağımsız değişkeni birlikte inceliyorsak çok değişkenli normalliği de kontrol etmeliyiz.
Çok değişkenli normalliğin incelenmesinde Mardia testi gibi yöntemler kullanılabilse de, pratikte tek değişkenli dağılımların incelenmesi, grafiksel kontroller ve çok değişkenli aykırı değerlerin değerlendirilmesi de önem taşır.
Özellikle büyük veri setlerinde küçük sapmaların istatistiksel olarak anlamlı çıkabileceği unutulmamalıdır.
Kovaryans matrislerinin homojenliği
MANOVA gibi yöntemlerde grupların yalnızca varyanslarının değil, değişkenler arasındaki kovaryans yapılarının da benzer olması beklenir.
Bunu kontrol etmek amacıyla Box’s M testi kullanılabilir.
Ancak Box’s M testi de oldukça duyarlı bir testtir. Bu nedenle sonuçları örneklem büyüklüğü ve diğer tanısal bulgularla birlikte değerlendirmek gerekir.
Çoklu doğrusal bağlantı
Çoklu regresyon gibi modellerde bağımsız değişkenlerin birbirleriyle aşırı derecede ilişkili olması önemli bir problemdir.
Örneğin modele birbirine çok benzeyen birkaç değişken aynı anda dahil edildiğinde, modelin katsayılarını yorumlamak güçleşebilir.
Burada en sık kullanılan göstergeler:
- VIF (Variance Inflation Factor)
- Tolerance
değerleridir.
Pratikte VIF için 5’in altında olması genellikle daha rahat bir alan olarak değerlendirilirken, 10’un üzerindeki değerler daha belirgin bir çoklu bağlantı sorununun işareti olarak kabul edilir. Ancak bunlar katı sınırlar değil, yorumlamaya yardımcı olan eşiklerdir.
Değişkenler arasındaki korelasyonların da incelenmesi yararlıdır. Çok yüksek korelasyonlar, modeldeki değişkenlerin birbirinden yeterince ayrışmadığına ilişkin bir uyarı oluşturabilir.
Homoskedastisite
Doğrusal regresyon gibi analizlerde hata varyanslarının tahmin edilen değerlerin farklı düzeylerinde yaklaşık olarak sabit olması beklenir.
Artıklar ile tahmin edilen değerlerin grafiğinde belirgin bir huni biçimi görülmesi, değişen varyans (heteroskedastisite) olasılığını düşündürebilir.
Bu durumda standart hata tahminleri etkilenebileceğinden, robust standart hatalar veya modele uygun başka yöntemler değerlendirilebilir.
Çok değişkenli aykırı değerler
Bir gözlem her bir değişken açısından tek başına olağan görünebilir; ancak değişkenler birlikte değerlendirildiğinde diğer gözlemlerden oldukça farklı bir konumda bulunabilir.
Bu nedenle çok değişkenli analizlerde Mahalanobis uzaklığı önemlidir.
Regresyon analizlerinde Cook’s Distance da belirli gözlemlerin model sonuçları üzerindeki etkisini değerlendirmeye yardımcı olur.
Örneklem büyüklüğü
Çok değişkenli analizlerde örneklem büyüklüğü ayrı bir başlık olarak ele alınabilir aslında.
Çünkü modele dahil edilen değişken sayısı arttıkça tahmin edilecek parametre sayısı da artar. Yetersiz örneklem, model katsayılarının kararsızlaşmasına ve standart hataların büyümesine neden olabilir.
Burada sık kullanılan “değişken başına 10–15 gözlem” gibi öneriler kaba rehberler, bize yalnızca fikir veren öneriler gibi düşünülmelidir, bütün analizler için geçerli evrensel kurallar değildir.
Özellikle faktör analizinde örneklem yeterliliği değerlendirilirken KMO, Bartlett testi, faktör yükleri ve faktör yapısının genel özellikleri gibi birden fazla gösterge birlikte ele alınmalıdır.
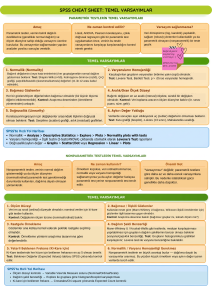
SPSS’te Varsayımların Kontrolü İçin:
Varsayım kontrolünün tamamını tek bir menüden yapmak mümkün değildir. Kullanılan analize göre farklı çıktılardan yararlanmak gerekir. Daha önce oluşturduğum cheat sheeti de buraya eklememin yararlı olacağını düşünüyorum.
Normallik
Analyze → Descriptive Statistics → Explore → Plots → Normality plots with tests
Burada histogram, Q-Q grafiği ve normallik testleri birlikte değerlendirilebilir.
Varyansların homojenliği
t-testi ve ANOVA gibi analizlerde ilgili çıktılarda Levene’s Test raporlanır.
Doğrusallık
Graphs → Scatter/Dot
veya regresyon analizinde artık grafiklerinden yararlanılabilir.
Aykırı değerler
Analyze → Descriptive Statistics → Explore
tek değişkenli aykırı değerlerin incelenmesinde kullanılabilir.
Regresyonda ise:
Analyze → Regression → Linear → Save
üzerinden Mahalanobis uzaklığı ve Cook’s Distance gibi ölçüler kaydedilebilir.
Çoklu bağlantısallık
Analyze → Regression → Linear → Statistics → Collinearity diagnostics
seçeneği üzerinden VIF ve Tolerance değerleri incelenebilir.
Çok değişkenli analizler
MANOVA için:
Analyze → General Linear Model → Multivariate
üzerinden ilgili homojenlik ve çok değişkenli analiz çıktıları değerlendirilebilir.
Peki varsayım ihlal edilirse ne yapacağız?

Varsayımlar sağlanamadığında, öncelikle bu ihlalin hangi varsayımda, ne ölçüde ve neden ortaya çıktığı anlaşılmalıdır.
Bazı durumlarda küçük sapmalar analiz sonuçlarını ciddi biçimde etkilemeyebilir. Özellikle yeterli örneklem büyüklüğünde bazı parametrik yöntemler dağılımsal sapmalara karşı oldukça dayanıklıdır.
Başka durumlarda ise farklı çözümler düşünülebilir:
- uygun bir veri dönüşümü yapmak,
- Welch gibi daha dayanıklı parametrik yöntemlere başvurmak,
- robust standart hatalar kullanmak,
- bootstrap yöntemlerinden yararlanmak,
- uygun bir nonparametrik yöntem seçmek,
- modelin yeniden kurulmasını değerlendirmek.
Şuna da dikkat edelim:“Normallik sağlanamadı, hemen veri dönüşümü yapalım” yaklaşımı da doğru değildir.
Veriyi yönteme uydurmak yerine, verinin yapısına uygun yöntemi seçmek daha doğru bir istatistiksel yaklaşımdır.

Özetle
Varsayımların testlere göre nasıl ele alındığını başka bir sayfada açıkladım. Sayfaya ulaşmak için buraya tıklayın.
| Analiz grubu | Ölçüm düzeyi / veri yapısı | Öne çıkan kontroller | SPSS’te sık kullanılan araçlar |
|---|---|---|---|
| Parametrik | Genellikle sürekli değişkenler | Normallik, varyansların homojenliği, bağımsızlık, doğrusallık, aykırı değerler | Explore, Levene, Scatterplot |
| Nonparametrik | Ordinal veriler veya dağılımsal varsayımların uygun olmadığı sürekli veriler; kategorik veriler için uygun testler | Bağımsızlık, araştırma desenine uygunluk, dağılımların yapısı, beklenen frekanslar | Explore, Frequencies, Nonparametric Tests |
| Çok değişkenli | Birden fazla değişkenin birlikte analiz edildiği modeller | Çok değişkenli normallik, kovaryans yapısı, çoklu bağlantı, doğrusallık, homoskedastisite, aykırı değerler, örneklem yeterliliği | Box’s M, VIF/Tolerance, Mahalanobis, Cook’s Distance |
Kılavuz sayfaya dönmek için buraya tıklayın.
Şimdilik benden bu kadar. Hepinize selamlar.
Doç. Dr. Fatma Betül KURNAZ